Traducido con un LLM del original en inglés. Leer el original
Super Smash Bros Melee salió en 2001 para la GameCube , y es uno de los videojuegos con el techo (y el suelo) de habilidad más alto que conozco; prueba de ello es que hay muchísima gente que lo sigue jugando de forma profesional. No soy nada bueno, SSB4 fue el único en el que eché horas, pero sé lo suficiente para entender su complejidad, y es impresionante. 1
Su dificultad se puede dividir en 2 niveles. A bajo nivel, el juego va a 60 fps y muchas técnicas tienen solo una ventana de 1-2 fotogramas para hacerlas bien (¡sin buffer de entradas!). Los jugadores competitivos de Melee hacen de media 6 acciones por segundo, y tienen que dominar técnicas como el wavedash, el L-cancel o el dash dance. Algunas de estas técnicas no las previeron los desarrolladores, lo que para mí lo hace aún más interesante.
En el nivel alto es más un juego mental. Los humanos reaccionan en unos 12 fotogramas y muchos ataques son más rápidos que eso, así que casi siempre estás prediciendo al rival, no reaccionando. Los buenos jugadores se pasan partidas enteras condicionando al otro para que espere algo. Disfruto viéndolo mucho más que cualquier otro juego de lucha porque no depende tanto de los combos y es mucho más “libre”.
Había visto algo de movimiento en twitter sobre avances recientes de bots de IA enfrentándose a algunos jugadores top, cosa que me pareció increíble, y decidí explorarlo durante 1hack , un evento donde nos juntamos 24 horas para construir lo que se nos ocurra, ¡y acabé dando una pequeña charla al final!
Empecé con una idea vaga de poner a LLM a jugar directamente. Algunas de las mejores formas de medir el rendimiento de los últimos modelos se basan en ponerlos a jugar a juegos fuera de su distribución de entrenamiento. La mayoría de benchmarks de juegos son por turnos (ajedrez, Pokémon, Slay the Spire … están saliendo un montón últimamente). Esto no funcionó como esperaba, pero me enganchó al tema; mi objetivo con este post es escribir lo que me habría gustado leer cuando empecé a aprender.
Creo que es un momento muy emocionante para meterse en esto, ¡con mucho trabajo por hacer y cosas fáciles por las que empezar!
Un poco de historia
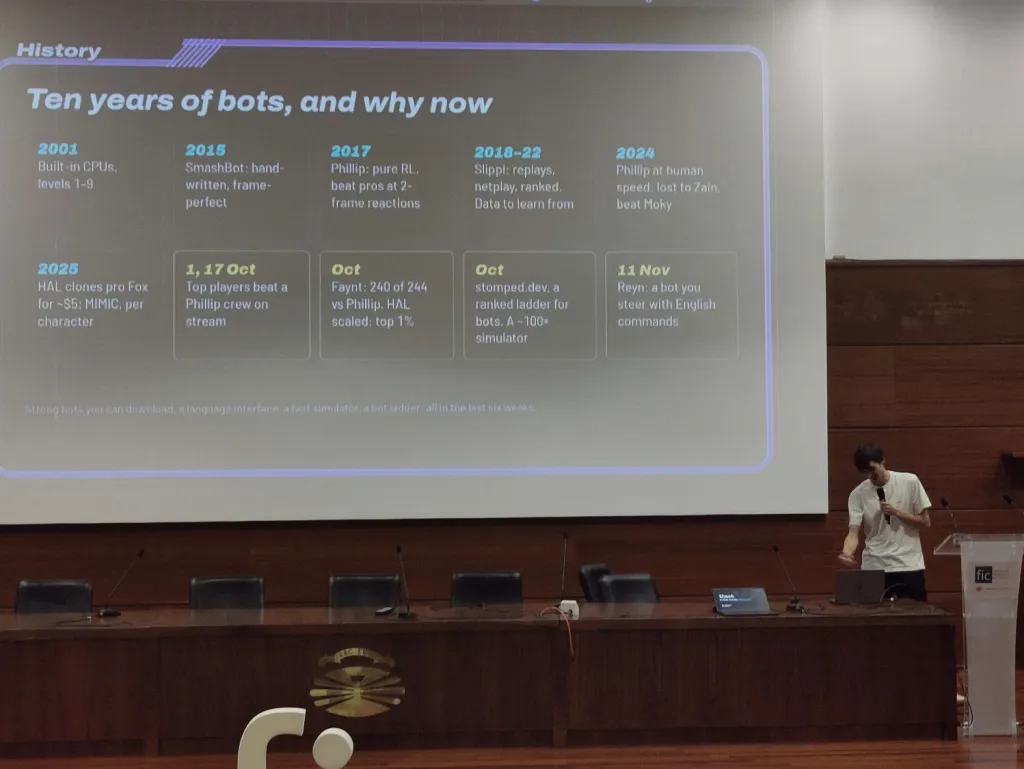
Melee en sí se hizo en unos 13 meses (rapidíiisimo) y fue el juego más vendido de la GameCube. El juego venía con CPU incorporadas, de nivel 1 a 9. No son gran cosa y cualquier jugador con experiencia les gana fácilmente, sobre todo porque repiten movimientos y estrategias constantemente. No fue hasta 2015 cuando Dan “altf4” Petro presentó SmashBot (¡gran charla de DEFCON!), un bot de Fox que escribió a mano usando GOFAI. Su principal ventaja era que actuaba perfecto al fotograma y con tiempo de reacción cero, pero los jugadores entendieron rápido sus tácticas y las explotaron hasta que se parchearon a mano. Aun así, el trabajo duro de hacer ingeniería inversa del juego acabó convirtiéndose en libmelee
 , sobre la que se construyen casi todos los bots desde entonces.
La partida de Melee óptima
Un breve intermedio para hablar de un experimento mental que Dan comparte al final de su charla: ¿qué jugarían dos bots perfectos entre sí? Me metí hasta el fondo de la madriguera con este.
El punto muerto por fuerza bruta4 min
Parafraseando, su respuesta fue:
Cualquier proyectil se puede reflejar en una ventana de dos fotogramas, así que lanzarlos no sirve de nada.
El movimiento más rápido del juego es el shine de Fox, que golpea en su primerísimo fotograma. Así que dos Fox perfectos caminan el uno hacia el otro hasta estar justo a distancia y hacen shine en el mismo fotograma. Los shines se anulan2, y a partir de ahí es un punto muerto.
Lo mejor para los dos es saltar y hacer multishine, perfecto al fotograma, hasta que se acabe el tiempo. Entonces la partida va a Muerte Súbita, donde caen bob-ombs del cielo, aparentemente al azar.
Pero no son aleatorias, el RNG de Melee es predecible3. La verdadera estrategia óptima es entonces llevar la partida para que, cuando el punto muerto acabe ocho minutos después, el generador esté en un estado que suelte las bombas donde tu rival tenga que elegir entre meterse en tu shine o en una bomba.
Como soy fan de este tipo de experimentos mentales, le busqué algunos agujeros, y como ahora tenemos el código fuente descompilado acabé intentando sacar la respuesta por fuerza bruta. Eso se convirtió en melee-brute, un fork que hice de melee-sim-light que puede explorar el espacio de búsqueda mucho más rápido que cualquier emulador tradicional. Sinceramente, es solo un montón de trucos ingeniosos de Fable optimizando para este caso de uso, ¡pero creo que puede ser bastante útil para otras cosas!
El punto muerto que menciona Dan sí parece real, pero no por ese motivo. Acercarse y hacer shine no es en realidad lo mejor. Como el ataque solo llega a unas 10 unidades, cualquier otro ataque, como el jab de Fox, que golpea desde 21, puede frenar al agresor mientras se acerca.
Luego pensé que a lo mejor algún otro personaje puede golpear a Fox de una forma a la que no pueda reaccionar (es un Fox perfecto, es como si pudiera leer la memoria del juego, así que ve cada movimiento en el fotograma en que empieza). Así que probé los movimientos de todos los personajes contra un Fox que responde al fotograma siguiente, desde una distancia de 12 a 404 unidades, y no pasó nada. El defensor puede castigar o bloquear cualquiera de los acercamientos.
El shine, que sale en el fotograma 1 mientras Fox es intangible, es lo que más bloquea. También es el único movimiento del juego que golpea antes de que cualquier rival perfecto teórico pueda reaccionar, así que nadie puede quedarse en ese pequeño círculo alrededor de Fox. Falco tiene el mismo shine, pero llega a 8 en vez de a 10.
Así que sabemos que la partida óptima tiene que ser un ditto de Fox, lo que en cierto modo deja todo el experimento sin sentido, porque cualquier plan que tenga un Fox, el otro puede jugarlo reflejado, y ninguno de los dos puede ir por delante desde el principio. 5 O los dos pueden quedarse ahí quietos y seguros para siempre (el punto muerto original), o los dos se ven obligados a adivinar de formas que, hasta donde he probado, siempre se equilibran al 50/50.
Por ejemplo, un Fox ataca y se acerca, para a 13,2 unidades de distancia y echa el stick hacia atrás de golpe. Ahora azul tiene que elegir entre hacer shine, apartarse o esperar, un piedra-papel-tijera sin una respuesta mejor ni peor.
Si el defensor nunca quiere adivinar, puede retroceder, lo que siempre es seguro aunque el atacante lo vea venir. El atacante podría intentar seguir acercándose hasta que no quede escenario. Una vez los dos están a distancia de shine sigue siendo un juego de adivinar, pero ya no está igualado. Jugado 100 veces, mirando 8 fotogramas por delante (unos 16 millones de estados de juego), el atacante conecta el primer golpe o el defensor se cae del escenario ≈ 34 veces, el defensor lo conecta ≈ 8, y ≈ 58 veces nadie recibe golpe.
Este acorralamiento solo funcionaría contra un Fox que se niega a adivinar nunca, y uno perfecto no tiene por qué. En medio del escenario, la adivinanza que ofrece el atacante vale lo mismo para los dos, así que puede aceptarla ahí en vez de retroceder hasta un borde malo.
Hasta donde puedo buscar, es tablas. Todavía queda mucho terreno por cubrir: mi búsqueda solo mira 8 fotogramas por delante y con un conjunto limitado de acciones. Hay más detalles de los experimentos en la página de Brute . Puede que se me escape algo, así que si tienes alguna idea, ¡escríbeme!
Volviendo a la historia
En 2017, Vlad Firoiu publicó Phillip, entrenado de principio a fin con RL asíncrono. Entrenó una red por personaje y usó una recompensa ingenua (KOs + daño hecho*peso) con actor-crítico y juego contra sí mismo. Llegó a ganar a algunos jugadores profesionales, aunque sobre todo porque podía reaccionar en unos 2 fotogramas cuando un humano necesita unos 12. Aun así era bastante explotable: algunos jugadores descubrieron que con solo agacharse en el borde acababa suicidándose.
Ese mismo año, Sharma y Friedman entrenaron una DQN recurrente que tenía que actuar con 12 fotogramas de retraso, más parecido a un humano. El propio seguimiento de Vlad en 2018 (“At Human Speed”) hizo lo mismo con Phillip: el RL a secas se hundía con el retraso, y añadir un modelo aprendido que predice el juego lo recuperaba.
En los años siguientes Slippi se hizo popular, con archivos de repetición, netplay con rollback, una clasificatoria… Acumular cientos de miles de partidas humanas grabadas de las que aprender cambió la receta: primero copiar a humanos, luego mejorar con RL. Project Nabla
 (Bryan Chen, 2022) fue un ejemplo temprano: una red recurrente pequeña clonada de unas 100k repeticiones de torneo, y luego PPO, jugando con 2 fotogramas de retraso.
Ninguno de estos bots mira la pantalla. Leen la memoria del juego en cada fotograma (posiciones, velocidades, animación y en qué punto va, daño) y responden con el estado completo de un mando. AlphaStar de DeepMind para StarCraft II siguió la misma receta: tiempo real, clonado de repeticiones humanas, y luego juego contra sí mismo con una penalización por alejarse del juego humano.
El gordo es el segundo Phillip de Vlad, slippi-ai: en desarrollo desde 2020 y jugando contra jugadores top en 2024, primero copió a humanos a partir de repeticiones de ranked y de profesionales, y luego mejoró jugando contra sí mismo, con un retraso de reacción humano incorporado: ve el juego con 18 a 24 fotogramas de retraso. Es una red recurrente que elige el mando en dos pasos, una de 728 combinaciones de botones, gatillos y C-stick, y luego una de 85 posiciones del stick principal.
No mucho después, en 2025, Eric Gu publicó HAL (solo Fox): un transformer de 20M clonado de partidas de Fox de profesionales por unos 5 $ de cómputo, que ganaba a la CPU de nivel 9 el 95% de las veces. erickfm llevó la misma receta a MIMIC, un modelo de unos 20M por personaje, con una cabeza dedicada a los botones para poder hacer wavedash y un poco de RL sobre cosas como el porcentaje de L-cancel. Luego llegó un HAL escalado: 247M de parámetros con 256 fotogramas de contexto, dirigido pidiéndole un nivel de juego o el estilo de un jugador. Predice 4 fotogramas de entradas a la vez para esconder su tiempo de cómputo.
Ahora, a finales de 2026, Frisson Labs publicó Faynt (artículo), un solo transformer de 10M de parámetros que juega con los 26 personajes. Se entrena en tres fases: clonación de comportamiento con unas 840.000 repeticiones de ranked, un “currículo de ganadores” que acaba en partidas ganadas por jugadores de rango Master (destilado de un hermano de 75M), y luego RL jugando contra sí mismo en espejos de Fox con 96 emuladores en una GPU. Juega con retraso de reacción cero y ganó 240 de 244 partidas contra las versiones públicas de Phillip. Le siguió Reyn, un bot que diriges con órdenes en inglés, pero sin ningún LLM dentro: Frisson etiquetó repeticiones humanas con instrucciones generadas por reglas (“esto es un agarre”), entrenó la política para seguirlas, y luego la congeló y entrenó pequeños adaptadores con RL. Un enrutador traduce lo que escribas a un menú fijo de unas 100 órdenes, o lo rechaza. Ese detalle importa más adelante.
14 segundos de una partida del benchmark, redibujados desde el archivo de repetición: Faynt (azul) le quita una vida a Phillip (rojo), los dos con Fox.
Todo este trabajo tan chulo lo hace posible la comunidad (como la recién abierta stomped.dev, una clasificatoria solo para bots con una comunidad de discord muy maja), que ha construido con el tiempo las herramientas abiertas que permiten este tipo de experimentos, y que hace poco usó IA para completar la descompilación de todo el código de Melee, de la que también salió melee-sim-light, que ejecuta el juego descompilado sin emulador, unas 100 veces más rápido que Dolphin sin interfaz.
TAS
Junto a los bots también hay una escena de juego asistido por herramientas (TAS), en la que se construye una secuencia fotograma a fotograma en un emulador. Se usa sobre todo para enseñar los límites del juego. Tengo la sensación de que mi fork podría ser útil aquí, pero nunca me metí, así que no estoy seguro.
Empezó en 2005 con vídeos de Action Replay hechos en el modo de depuración oculto del juego, que avanza fotograma a fotograma. Hacia 2010 Dolphin tuvo herramientas TAS de verdad (estados guardados, avance por fotograma, películas de entradas), y más tarde scripts en Lua encima, como ssbm-lua-core de PracticalTAS. Algunas obras chulas: combos que acaban todos en exactamente 69 golpes, y Target Test con los 25 personajes. Muchos hallazgos vuelven al juego humano.
Benchmark
Usando el emulador Dolphin de Slippi, Fox contra Fox en FD y Battlefield, metí todos los bots relevantes que encontré y un par de experimentos míos. Todo entra en un único ajuste Elo con la CPU de nivel 9 fijada en 1500. Luego lo dejé toda la noche jugando miles de partidas.
Los LLM son un caso especial, porque son demasiado lentos para pulsar botones en cada fotograma (16,7 ms), así que cada montaje les da una tarea de más alto nivel y deja los fotogramas a algo más rápido. Leen unos 500 tokens de estado del juego con una ventana de contexto deslizante.
- Juegan, sin límite de tiempo: eligen un movimiento y el juego se pausa mientras piensan. Esto mide lo buenas que son sus decisiones.
- Juegan, en directo: lo mismo pero sin pausas.
- Reyn con coach: Reyn juega cada fotograma, y cada 5 segundos el LLM coach usa texto para condicionar su estilo de juego.
- Escriben un bot: un agente de programación tiene 30 minutos, un sandbox y una herramienta de práctica para escribir un bot en Python que luego juega como cualquier otro participante.
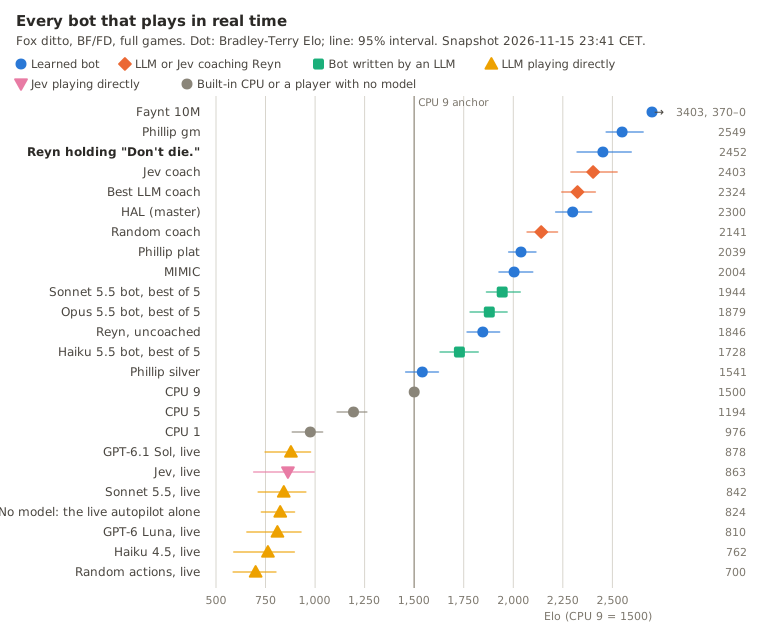
¡Los bots aprendidos van muy por delante!
LLM
Jugando
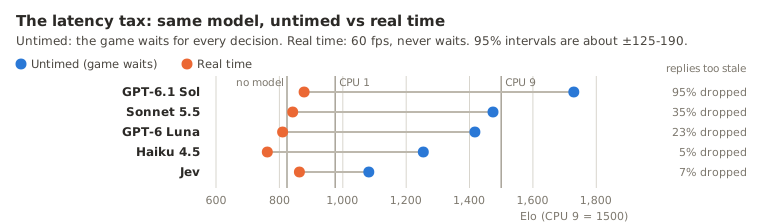
Con tiempo para pensar, GPT-6.1 Sol gana a la CPU de nivel 9 (1729). En directo, todo eso desaparece: todos los modelos caen de 492 a 851 puntos, por debajo de la CPU de nivel 1 (de 762 a 878).
Las capturas de pantalla tampoco ayudan: con una imagen en lugar del texto, los modelos rindieron en general peor. LLM Colosseum vio algo parecido en Street Fighter.
Como coach
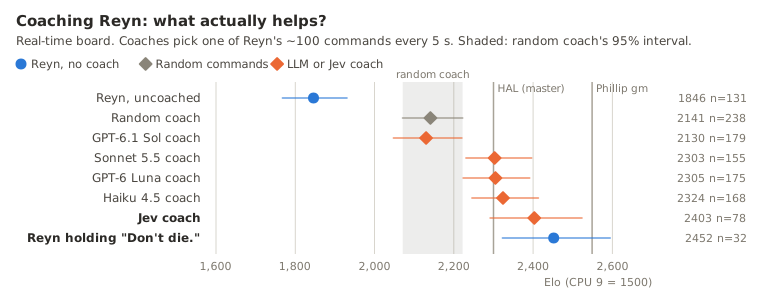
Reyn solo puntúa 1846. Con un LLM eligiendo una de sus ~100 órdenes cada 5 segundos, sube a unos 2300, el nivel de HAL. Sorprendentemente, Reyn manteniendo “Don’t die.” (“no te mueras”) toda la partida, sin ningún coach, llega a 2452, por encima de todos los LLM.
Programando
Le di a Claude Code 30 minutos, un sandbox y una herramienta de práctica para escribir un bot en Python, partiendo de un bot de 60 líneas que va a por el rival y hace up-smash. Resulta que ese bot inicial ya está por encima de la CPU de nivel 9.
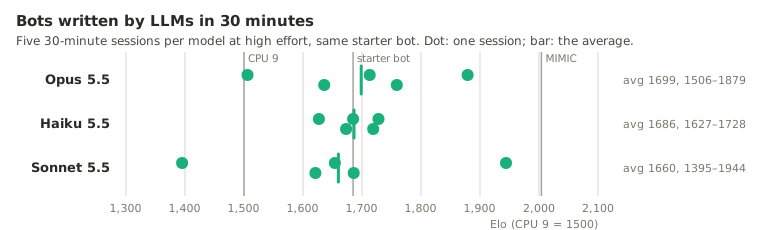
Los tres acaban al nivel del bot inicial: Opus 1699 de media, Haiku 1686, Sonnet 1660. Las sesiones del mismo modelo difieren en cientos de puntos.
Entrenando mi propio bot
Después de encontrar un cruce entre aficiones mías como Melee y entrenar redes neuronales, lo natural era entrenar mis propios bots de IA. Estos han sido mis primeros pasos, apenas estoy entrando en la comunidad y entendiendo el estado del arte, ¡así que puede que haga una actualización más adelante!
Mi objetivo era hacer el mejor Yoshi (mi main) que pudiera. Empecé entrenando mi propio transformer pequeño con repeticiones humanas de Yoshi, como hace HAL. El mejor ganaba a la CPU de nivel 9, pero perdía todas las partidas contra los bots serios, y el RL jugando contra sí mismo en el simulador lo empeoraba en el juego real. Para comprobar mi pipeline reentrené con él el Fox de 20M de HAL y encontré un montón de bugs… También probé a hacer algunas primitivas para técnicas concretas de Yoshi y etiquetarlas en los datos de entrenamiento, pero no pareció servir de mucho.
El retraso parece uno de los mayores problemas por resolver. En stomped.dev el bot ve el juego con 10 fotogramas de retraso si juega desde mi servidor6, lo que afecta mucho a su rendimiento. Sigue haciendo double-jump cancel y L-cancel, pero los parries, que tienen que caer en los 6 fotogramas de arranque del escudo de Yoshi, pasan de 0,17 por minuto a casi ninguno (0,02).
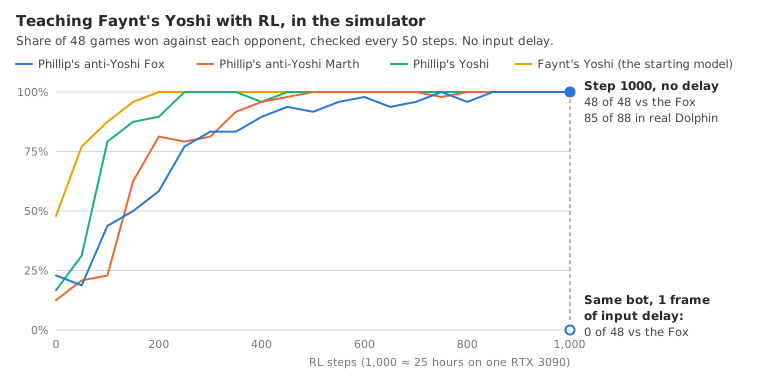
Al final cambié la base al modelo de 10M de Faynt, que juega con Yoshi mejor que HAL de serie, y monté RL contra los bots anti-Yoshi de Phillip dentro de melee-sim-light (60 veces más rápido que Dolphin). Tras 1.000 pasos (más o menos un día en mi 3090) ganó 85 de 88 partidas en Dolphin, de lejos mi mejor Yoshi, pero solo sin retraso. Ahora lo estoy entrenando más, subiendo el retraso poco a poco hasta 10 fotogramas; ya veremos cómo sale.
Otras cosas
Una web donde fui apuntando mis investigaciones y experimentos, con cada partida que se juega en directo en 2D y mis entrenamientos de modelos en directo, entre otras cosas.
Una cabina de comentarios con IA con dos comentaristas. Un LLM rápido sigue los eventos de la partida y ElevenLabs les pone voz.
También estoy buscando cosas interesantes que hacer con melee-brute. A su velocidad actual, solo puede llegar a una conclusión en situaciones muy restringidas, pero para preguntas como “¿había alguna forma posible de sobrevivir a este edgeguard concreto?” puede funcionar.
También estoy pensando en habilitar una forma de jugar contra mis bots en directo por netplay si hay interés. ¡Háblame!
Si te interesa saber más, ¡recomiendo mucho AsumSaus
y PracticalTAS! ↩︎Si los dos hacen shine en el mismo fotograma en el suelo, no se anulan en una guerra de multishines: las hitboxes chocan y los dos se congelan 4 fotogramas. ↩︎
Sería prácticamente imposible que el bot controlase el RNG, porque los movimientos del rival también lo hacen avanzar. Además, con las reglas de torneo no hay Muerte Súbita: si se acaba el tiempo gana quien tenga menos porcentaje, y un empate a porcentaje se repite como una partida a una sola vida de 2 o 3 minutos, que se quedaría en punto muerto igual. ↩︎
Porque es lo más cerca que cualquier personaje puede ponerse de él en las mejores circunstancias. ↩︎
Más o menos, Melee es un juego raro; por ejemplo, algunos empates exactos se resuelven por orden de puerto. Aun así, que los dos ataquen en el mismo fotograma sí acaba igualado, y a distancia de shine un agarre pierde contra el shine, así que esto no rompe el punto muerto, que yo sepa. ↩︎
Serían solo 2 si alquilase una máquina al lado de su servidor, pero me apetece un poco el reto ↩︎